
Open Weights Models
Journaux liées à cette note :
Septembre 2026 - je code avec des open weights pour 10 à 30 € par mois
Depuis mi-mars 2026, je suis passé des modèles Anthropic aux modèles Open Weights proposés par OpenCode Go au quotidien.
- En mars j'ai commencé par MiniMax M2.5
- En avril, principalement Kimi K2.5
- En mai, Kimi K2.6
- En juin et juillet DeepSeek-V4-Flash preview
- En août DeepSeek-V4-Flash 0731
- En septembre DeepSeek-V4.1-Flash
Comme le montre la liste ci-dessus, j'utilise les modèles Flash de DeepSeek depuis juin. Je les utilise soit via l'AI provider DeepSeek, soit à travers OpenCode Go.
OpenCode Go plafonne à 10 $ par compte. Fin août, face à la hausse soudaine des tarifs de DeepSeek Flash (annonce du 13 août 2026, discussion sur Hacker News), j'ai ouvert un second compte pour dépasser ce plafond : j'utilise donc deux comptes OpenCode Go à 10 $ par mois (soit 2 × 10 $). Au-delà de 20 $, ou si OpenCode Go est indisponible, je bascule sur le provider DeepSeek direct avec ces tarifs en mode Pay-As-You-Go.
Ces modèles me satisfont pleinement, tant pour le coding que pour l'analyse de texte, la réflexion ou l'aide à l'écriture. Et tout cela à un prix beaucoup plus compétitif que les offres OpenAI ou Anthropic : sur toute cette période, je suis resté entre 10 et 30 € par mois pour du coding.
Je précise tout de même qu'à côté de ces LLM, je possède toujours un abonnement Claude Pro à 18 € HT par mois, que j'utilise principalement sur mon smartphone. Je compte clôturer cet abonnement et à la place, utiliser sur mon smartphone OpenChamber connecté à OpenCode, connecté à DeepSeek V4.1-Flash, mais à ce jour, ce n'est toujours pas fait.
Mon impression de performance des modèles DeepSeek Flash est corroborée par les benchmarks.
Je ne veux pas me lancer, dans cet article, dans une analyse rigoureuse des différents modèles, ce que synthétise de toute façon bien mieux que moi Artificial Analysis.
Je me contenterai ici de partager seulement le benchmark Artificial Analysis Intelligence Index: Score :

Avec Opus 4.5, sorti en novembre 2025, un tournant reconnu dans la communauté s'est produit, et la pratique du coding agentique s'est diffusée (par exemple l'avis du créateur de Redis). Dans cette liste, j'ai sélectionné volontairement ce modèle comme mon jalon, ainsi que Claude Sonnet 4.6, sorti en février 2026, qui atteint empiriquement la même qualité de code pour un prix moindre.
Dans cette liste, j'ai inclus Mistral Medium 3.5, qui est, il me semble, au moment où j'écris ces lignes, le plus puissant de leurs modèles. On peut voir qu'il est en retard sur cet indice par rapport à la plupart des modèles actuels ; de mon côté, je ne vois personne l'utiliser.
Je pars du principe que tout ce qui atteint la qualité d'Opus 4.5 — donc a fortiori de Sonnet 4.6 — m'est utile. À partir de là, comme c'est moi qui paie mes crédits LLM et non mon entreprise — contrairement à la plupart de mes amis qui se préoccupent peu du coût — ce qui m'importe avant tout, c'est le prix et la vitesse de rendu. Sur le prix, la différence est réelle, comme l'illustre le benchmark Cost per Intelligence Index Task :

À tâche d'intelligence égale, DeepSeek Flash coûte une fraction de Sonnet 4.6, Sonnet 5 ou Opus 5.
En bas de cette note, j'ai dressé une liste de benchmarks qui comparent les modèles DeepSeek Flash avec 3 jalons : Sonnet 4.6, qui me sert de référence basse en tant qu'équivalent empirique d'Opus 4.5, puis Sonnet 5 et Claude Opus 5. Les modèles DeepSeek Flash s'y positionnent très bien par rapport à ces modèles de référence.
La seule exception notable est le benchmark AA-Omniscience Index: Score :
 2.png)
Pour éviter cela, je peux utiliser Kimi K3 ou GLM-5.3 qui se débrouillent aussi bien que Sonnet 5 dans ce benchmark.
Précision tout de même, le benchmark "AA-Omniscience: Evaluating Cross-Domain Knowledge Reliability in Large Language Models" exécute ses tests sans harness permettant au LLM de vérifier ses réponses à l'aide d'un RAG (recherche sur Internet ou autre). C'est une situation plus difficile que la situation réelle. Je ne remets pas en cause ce benchmark, je le prends en compte, mais dans ma pratique quotidienne je ne pense pas être impacté, car je configure mes harness pour toujours faire des vérifications. En pratique, lors des tâches de coding, c'est le bon fonctionnement du programme qui rattrape les hallucinations du LLM ; pour mes tâches d'écriture et d'analyse, c'est ma vérification des sources qui me permet de contredire le LLM en cas d'hallucination.
Annexe : liste de benchmarks
 (11 Sep '26).png)
.png)
.png)
.png)
.png)
.png)
.png)
.png)
.png)
Je suis ravi de voir l'offre de modèles OpenCode Go s'enrichir semaine après semaine
Le 12 mars 2026, quand j'ai commencé à utiliser OpenCode Go, seuls 3 modèles étaient disponibles : MiniMax M2.5, Kimi K2.5 et GLM-5. J'ai depuis eu l'agréable surprise de voir arriver de nouveaux modèles Open Weights, souvent dès le lendemain de leur publication.
Aujourd'hui, l'offre est bien plus vaste :
- 18 mars, ajout de MiniMax M2.7
- 19 mars OpenCode supprime le support d'accès à l'offre Claude Pro
- 2 avril, ajout de MiMo-V2-Pro et MiMo-V2-Omni de Xiaomi
- 7 avril, ajout de GLM-5.1
- 15 avril, ajout de Qwen 3.5 Plus et Qwen3.6 Plus
- 20 avril, ajout de Kimi K2.6
- 22 avril, ajout de MiMo v2.5 et MiMo v2.5 Pro de Xiaomi
- 24 avril, ajout de DeepSeek V4 Pro et DeepSeek V4 Flash
Et depuis, j'ai pris la fâcheuse habitude — un peu par FoMo, je l'avoue — de consulter presque une fois par jour le compte Twitter de OpenCode (https://xcancel.com/opencode/) pour voir si un nouveau modèle est sorti.
Je découvre l'offre "Go" de OpenCode, « Go - Modèles de code à faible coût pour tous », qui semble être sortie le 25 février 2026 : https://xcancel.com/opencode/status/2026553685468135886.
Je n'ai rien trouvé à ce sujet sur Hacker News ni chez Simon Willison.
D'après ce que je comprends, alors que l'offre OpenCode Zen propose un point d'accès et une facturation unifiés du type Pay-As-You-Go, comme OpenRouter, OpenCode Go est une offre d'abonnement à 10 dollars par mois, selon les mêmes principes que les plans d'abonnement comme Anthropic Claude Pro, Max, etc.
L'offre OpenCode Go propose un accès uniquement à 3 LLMs, tous Open Weights et tous chinois : GLM-5, Kimi K2.5 et MiniMax M2.5.
À noter toutefois que OpenCode Go n'utilise aucun AI provider basé en Chine :
Privacy : The plan is designed primarily for international users, with models hosted in the US, EU, and Singapore for stable global access.
Contrairement à Anthropic (voir Est-ce qu'un abonnement Claude est réellement plus économique qu'un accès direct via l'API ?), OpenCode semble être transparent sur leur offre :
Usage limits
OpenCode Go includes the following limits:
- 5 hour limit — $12 of usage
- Weekly limit — $30 of usage
- Monthly limit — $60 of usage
Limits are defined in dollar value. This means your actual request count depends on the model you use. Cheaper models like MiniMax M2.5 allow for more requests, while higher-cost models like GLM-5 allow for fewer.
The table below provides an estimated request count based on typical Go usage patterns:
GLM-5 Kimi K2.5 MiniMax M2.5 requests per 5 hour 1,150 1,850 20,000 requests per week 2,880 4,630 50,000 requests per month 5,750 9,250 100,000 Estimates are based on observed average request patterns:
- GLM-5 — 700 input, 52,000 cached, 150 output tokens per request
- Kimi K2.5 — 870 input, 55,000 cached, 200 output tokens per request
- MiniMax M2.5 — 300 input, 55,000 cached, 125 output tokens per request
You can track your current usage in the console.
Comparaison des prix au million de tokens des plans Claude Max et OpenCode Go
Si je pars des prix listés sur l'offre OpenCode Zen et les prix de Sonnet 4.6 chez Anthropic, je peux dresser le tableau suivant, prix exprimé en millions de tokens :
| Model | Input | Output | Cached Read | Cached Write |
|---|---|---|---|---|
| MiniMax M2.5 | $0.30 | $1.20 | $0.06 | $0.375 |
| GLM 5 | $1.00 | $3.20 | $0.20 | - |
| Kimi K2.5 | $0.60 | $3.00 | $0.10 | - |
| Sonnet 4.6 | $3.00 | $15.00 | $0.30 | $3.75 |
Ensuite, j'ajuste ces prix avec les réductions offertes :
- par le plan Claude Max à $100 / mois, soit une réduction de 92,56 % (
(1345 - 100) / 1345 × 100 = 92,56 %) - par OpenCode Go, soit une réduction de 83,33 % (
(60 - 10) / 60 × 100 = 83,33 %)
Cela donne :
| Model | Input | Output | Cached Read | Cached Write |
|---|---|---|---|---|
| MiniMax M2.5 (avec offre Go) | $0.05 | $0.20 | $0.01 | $0.06 |
| GLM 5 (avec offre Go) | $0.16 | $0.53 | $0.03 | - |
| Kimi K2.5 (avec offre Go) | $0.10 | $0.50 | $0.01 | - |
| Sonnet 4.6 (avec offre Max) | $0.22 | $1.11 | $0.02 | $0.27 |
Sur la base du leaderboard SWE-bench Verified, je vais partir des hypothèses suivantes :
- Si je considère arbitrairement que GLM-5 est équivalent à Sonnet 4.6, alors l'offre OpenCode Go est légèrement moins cher que l'offre Claude Max
- Si je considère arbitrairement que Kimi K2.5 est équivalent à Sonnet 4.6, alors l'offre OpenCode Go est deux fois moins cher que l'offre Claude Max
#JaiDécidé de tester l'offre OpenCode Go sur un projet d'outil d'archivage à froid de conversations Mattermost en Golang que je coderai from scratch. Je compte réaliser deux versions de ce projet en parallèle : une version avec Sonnet 4.6 et l'autre avec les modèles de OpenCode Go.
J'ai découvert le modèle Open Weights GLM-5
#JaiDécouvert le modèle GLM-5 Open Weights de la société chinoise Z.ai : https://glm5.net
- Note de Simon Willison : https://simonwillison.net/2026/Feb/11/glm-5/
- Thread Hacker News : GLM-5: Targeting complex systems engineering and long-horizon agentic tasks
Analyse de Sonnet 4.6 des commentaires :
En se basant sur les retours concrets du fil, GLM-5 impressionne pour le coding agentique : cmrdporcupine rapporte un refactoring réussi dans un langage propriétaire pour seulement $1.50, avec une analyse initiale meilleure que GPT 5.3. Plusieurs utilisateurs le positionnent au niveau d'Opus 4.5 voire au-delà pour les tâches bien définies, à une fraction du coût. Le plan coding de Z.ai est cité comme une alternative crédible aux abonnements Anthropic, dont les limites d'usage dégradées poussent beaucoup à chercher ailleurs. Le scepticisme subsiste néanmoins sur le benchmaxxing — les comparaisons publiées portent sur Opus 4.5 et non sur Opus 4.6, la dernière génération.
Je constate que GLM-5 est mentionné / conseillé dans le README.md de Oh My OpenCode :
Even only with following subscriptions, ultrawork will work well (this project is not affiliated, this is just personal recommendation):
- ChatGPT Subscription ($20)
- Kimi Code Subscription ($0.99) (*only this month)
- GLM Coding Plan ($10)
- If you are eligible for pay-per-token, using kimi and gemini models won't cost you that much.
et
- Sisyphus (
claude-opus-4-6/kimi-k2.5/glm-5) is your main orchestrator. He plans, delegates to specialists, and drives tasks to completion with aggressive parallel execution. He does not stop halfway.- Hephaestus (
gpt-5.3-codex) is your autonomous deep worker. Give him a goal, not a recipe. He explores the codebase, researches patterns, and executes end-to-end without hand-holding. The Legitimate Craftsman.- Prometheus (
claude-opus-4-6/kimi-k2.5/glm-5) is your strategic planner. Interview mode: it questions, identifies scope, and builds a detailed plan before a single line of code is touched.
J'observe que GLM-5 est plutôt bien placé dans les leaderboard SWE-bench :
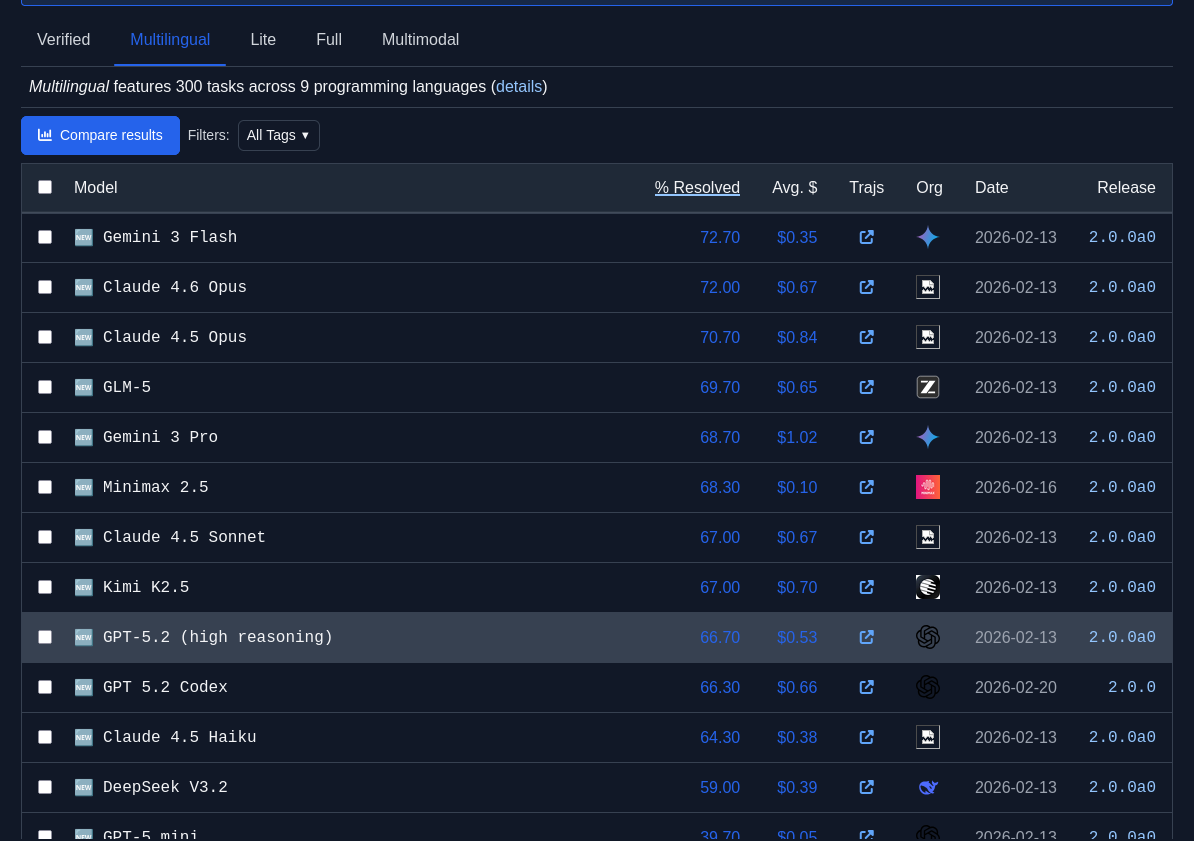
Je constate que GLM-5 est meilleur que Devstral 2 (Mistral) qui a un score de 61.3%.